文章 "MQL5 中的 SQLite 功能示例:按交易品种及 Magic 编码展示交易统计信息的仪表盘"
目前缺乏能让您处理大量交易历史记录的工具。
遗憾的是,这个工具包和其他许多工具包一样,在请求历史记录时就会挂掉。
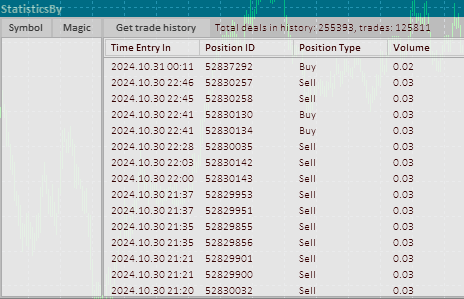
获取历史记录需要五分钟。然后就无法在窗口中进行任何操作了--CPU 负载过大。
不想在莫斯科证券交易所工作
不,不,不
也许PostgreSWL会更好。不过,文章作者在表上没有使用索引,如果你看看那些查询语句,就会明白为什么它只能在数据集很小的时候才能流畅运行。如果应用了索引,并针对这些索引优化查询,它处理大型数据集也完全没问题。
保存结构体只有在你不需要查询数据、仅需加载数据时才有用。如果你需要查询数据,没有什么能比得上 SQL。
不不不
在我们的场景中(当你没有100500个客户时),SQLite对PostgreSQL的性能优势简直像公牛追赶绵羊一样明显。不过话说回来,TS本来就不是DBA,也没接触过数据库 :-) 文章里提到的所有内容都无法避免性能瓶颈
那里既没有索引,又有那些该死的带有双重聚合的嵌套查询,数据库还承受着应用的负载,而这篇文章写得这么夸张,你们也明白是为了什么。
ps/ 为了避免争论,不妨在相关技术论坛上问问大家,这个查询到底哪里不对
//--- 按Magic Number获取各交易机器人(顾问)的交易统计数据
   request=DatabasePrepare(db, "SELECT r.*,"
                           "   (case when r.trades != 0 then (r.gross_profit+r.gross_loss)/r.trades else 0 end) as expected_payoff,"
                           "   (case when r.trades != 0 then r.win_trades*100.0/r.trades else 0 end) as win_percent,"
                           "   (case when r.trades != 0 then r.loss_trades*100.0/r.trades else 0 end) as loss_percent,"
                           "   r.gross_profit/r.win_trades as average_profit,"
                           "   r.gross_loss/r.loss_trades as average_loss,"
                           "   (case when r.gross_loss!=0.0 then r.gross_profit/(-r.gross_loss) else 0 end) as profit_factor "
                           "FROM "
                           "   ("
                           "   SELECT MAGIC,"
                           "   sum(case when entry =1 then 1 else 0 end) as trades,"
                           "   sum(case when profit > 0 then profit else 0 end) as gross_profit,"
                           "   sum(case when profit < 0 then profit else 0 end) as gross_loss,"
                           "   sum(swap) as total_swap,"
                           "   sum(commission) as total_commission,"
                           "   sum(profit) as total_profit,"
                           "   sum(profit+swap+commission) as net_profit,"
                           "   sum(case when profit > 0 then 1 else 0 end) as win_trades,"
                           "   sum(case when profit < 0 then 1 else 0 end) as loss_trades "
                           "   FROM DEALS "
                           "   WHERE SYMBOL <> '' and SYMBOL is not NULL "
                           "   GROUP BY MAGIC"
                           "   ) as r");
简而言之,长话短说,以免被人说我在吹毛求疵:
SYMBOL 必须设置为 TEXT NOT NULL 类型。在SQLite 中,数据类型非常有限:int、real、text、blob(而且这些都是可选的,可以不指定)。NOT NULL 可以避免在每次查询中都进行毫无意义的 WHERE SYMBOL NOT NULL 检查
ID、TRADE_ID 以及类似字段不仅是 KEY,更是 PRIMARY KEY
经常出现在 WHERE、GROUP BY 子句中的字段,最好建立索引。当前模式中索引不足,导致查询速度变慢。关于 EXPLAIN 的内容请见下文
最好“批量”填充数据库。 针对每笔交易单独执行 INSERT 操作会非常、非常耗时。如果可能,应尽量在单次查询中批量提交 100 条记录。(理想情况下,应在每次启动时进行同步,而不仅仅是在创建时填充)
查询中存在大量冗余计算,其中部分内容可以/应该转移到客户端处理。嵌套的SELECT本身就是一个不祥的信号;如果实在别无他法,就必须单独使用EXPLAIN进行分析,并优化数据库和查询。
对于实际应用和大量事务处理,当然需要分页和虚拟表(即根据需要将数据加载到视图中,而不是保留庞大的结构数组),但这可能超出了本文的讨论范围。
---
归根结底,只是数据库模式设计不周全,所以fxsaber才变得如此迟缓。合理地修正并完善模式,优化查询,只需进行最少的修改,系统应该就能正常运行了。

新文章 MQL5 中的 SQLite 功能示例:按交易品种及 Magic 编码展示交易统计信息的仪表盘已发布:
该函数用于绘制所选交易品种、magic编码或整个账户的最终统计表格。该函数接收统计表格的类型,以及交易品种的名称、magic编码的字符串值或账户号码。文本确定了交易品种、magic编码或账户在相应的统计数据结构数组中的索引。我们使用获得的索引从所需的结构体中获取所有统计数据,然后将它们根据单元格的坐标在渲染的表格中进行排列。在这种情况下,显示文本的水平偏移量是这样计算的:数据标题绑定到表格单元格的左边缘,而数据值的文本绑定到其表格单元格的右边缘。所有数据都显示在四列中,以便它们在面板上视觉上以两列的形式分组显示,即“标题 – 值”。
让我们编译这个指标,看看我们得到了什么:
我们可以看到,所有声明的功能都按预期工作。我们可以看到,当移动光标和滚动表格时,表格中的文本有轻微的“闪烁”。但这是一种次优重绘方案的结果——表格的整个可见部分都在不断重绘。可以通过更复杂的处理鼠标下表格行的逻辑来避免这种情况,但这尚不再本文考虑范围内。
作者:Artyom Trishkin