記事「MQL5におけるSQLiteの機能:銘柄とマジックナンバー別の取引統計を表示するダッシュボード」についてのディスカッション
大量の取引履歴を扱うことができるツールが不足している。
残念なことに、このツールキットは、他の多くのツールと同様、履歴を要求すると単にハングアップする。
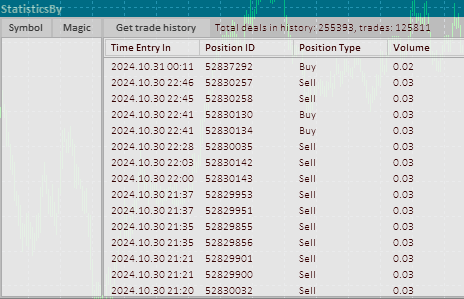
履歴を取得するのに5分かかる。その後、ウィンドウを使って何かをすることは不可能である。
モスクワ証券取引所で働きたくない
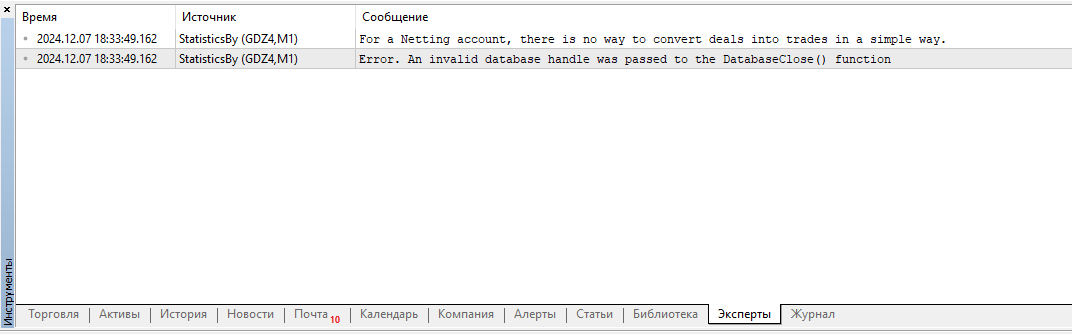
膨大な取引履歴を扱うためのツールが不足している。
残念ながら、このツールも他の多くのツールと同様、取引履歴を照会しようとするとフリーズしてしまいます。
履歴の取得に5分かかります。その後、ウィンドウで何も操作できなくなり、CPUがフル稼働したままになります。
いや、いや、いや
おそらくPostgreSWLの方が良いかもしれません。しかし、この記事の著者はテーブルにインデックスを使用しておらず、クエリを見てみると、なぜごく少量のデータセットでしかレスポンシブに動作しないのかがわかります。インデックスを適用し、そのインデックスに合わせたクエリを記述すれば、大規模なデータセットでも問題なく処理できます。
構造体を保存するのは、データをクエリする必要がなく、単に読み込むだけの場合にのみ有用です。データをクエリする必要があるなら、SQLに勝るものはありません。
いや、いや、いや
私たちの環境(顧客数が100,500人にも満たない場合)では、SQLiteはPostgreSQLを牛が羊を倒すように圧倒します。ただ、TSはそもそもDBAではなく、データベースの扱いに慣れていないという事情もあります :-) 記事に書かれている内容では、処理が遅くなるのは避けられません
そこにはインデックスもなく、二重集計を伴うめちゃくちゃなネストされたクエリがあり、データベースへの負荷も大きい。記事は、まあご想像の通り、あの目的のために書かれたものです。
ps/ 議論を避けるために、専門サイトなどでそのクエリのどこが間違っているのか尋ねてみてください
//--- マジックナンバー別に、EAごとの取引統計を取得する
   request=DatabasePrepare(db, "SELECT r.*,"
                           "   (case when r.trades != 0 then (r.gross_profit+r.gross_loss)/r.trades else 0 end) as expected_payoff,"
                           "   (case when r.trades != 0 then r.win_trades*100.0/r.trades else 0 end) as win_percent,"
                           "   (case when r.trades != 0 then r.loss_trades*100.0/r.trades else 0 end) as loss_percent,"
                           "   r.gross_profit/r.win_trades as average_profit,"
                           "   r.gross_loss/r.loss_trades as average_loss,"
                           "   (case when r.gross_loss!=0.0 then r.gross_profit/(-r.gross_loss) else 0 end) as profit_factor "
                           "FROM "
                           "   ("
                           "   SELECT MAGIC,"
                           "   sum(case when entry =1 then 1 else 0 end) as trades,"
                           "   sum(case when profit > 0 then profit else 0 end) as gross_profit,"
                           "   sum(case when profit < 0 then profit else 0 end) as gross_loss,"
                           "   sum(swap) as total_swap,"
                           "   sum(commission) as total_commission,"
                           "   sum(profit) as total_profit,"
                           "   sum(profit+swap+commission) as net_profit,"
                           "   sum(case when profit > 0 then 1 else 0 end) as win_trades,"
                           "   sum(case when profit < 0 then 1 else 0 end) as loss_trades "
                           "   FROM DEALS "
                           "   WHERE SYMBOL <> '' and SYMBOL is not NULL "
                           "   GROUP BY MAGIC"
                           "   ) as r");
手短に、細かいことを言っていると言われるのを避けるために:
SYMBOLのデータ型はTEXT NOT NULLでなければなりません。SQLiteの データ型はごくわずかです:int、real、text、blob(しかもこれらはオプションであり、指定しなくても構いません)。NOT NULLを指定することで、各クエリでWHERE SYMBOL NOT NULLといった無意味なチェックを行う必要がなくなります
ID、TRADE_IDなどは単なるKEYではなく、PRIMARY KEYです
WHEREやGROUP BYの式で頻繁に使用されるフィールドには、インデックスを付けるのが有効です。スキーマ内のインデックスが不足しているため、クエリの処理が遅くなっています。EXPLAINについては後述します
データベースへのデータ投入は「一括」で行うのが望ましい。 取引ごとにINSERTを行うと、非常に時間がかかります。 可能であれば、1回のクエリで100件のレコードを送信できるようにしましょう。(理想を言えば、作成時に単にデータを投入するだけでなく、起動のたびに同期を行うべきです)
クエリには重複した計算が多く、アプリケーション側に移管できる/移管すべき処理も含まれています。ネストされたSELECT文自体は悪い兆候です。どうしても避けられない場合は、別途EXPLAINを実行して、データベースとクエリを最適化する必要があります。
実運用や大量のトランザクションを扱う場合、当然ながらページネーションや仮想テーブル(必要に応じてビューにデータを読み込み、膨大な構造配列を保持しないようにするもの)が必要になりますが、これはおそらくこの記事の範疇を超えるでしょう。
---
結局のところ、データベースのスキーマが十分に検討されていないため、fxsaberではすべてが重くなってしまったのです。スキーマを適切に修正・補完し、クエリを最適化すれば、最小限の修正で動作するはずです。

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
新しい記事「MQL5におけるSQLiteの機能:銘柄とマジックナンバー別の取引統計を表示するダッシュボード」はパブリッシュされました:
この関数は、選択された銘柄、マジックナンバー、または口座全体に対する最終的な統計テーブルを描画するために設計されています。関数は、統計テーブルの種類、およびシンボル名、マジックナンバーの文字列値、またはアカウント番号を受け取ります。渡された文字列から、対応する統計データ構造体配列内の銘柄、マジックナンバー、またはアカウントのインデックスを特定します。必要な構造体データは、取得したインデックスを使用して抽出され、次にテーブルのセル座標に従って描画されたテーブル内に配置されます。このとき、表示されるテキストの水平方向のオフセットは、見出しがテーブルセルの左端に揃えられ、値のテキストがセルの右端に揃えられるように計算されます。すべてのデータは4列で表示され、パネル上で視覚的に「項目名 -- 値」の2列構成が2セットにグループ化される形式になります。
インジケーターをコンパイルして、結果を確認してみましょう。
すべての宣言された機能が期待通りに動作していることが確認できます。テーブル内のテキストが、カーソルを動かしたりスクロールしたりする際にわずかに「点滅」して見えることがありますが、これは最適でない再描画方式によるもので、テーブルの表示部分全体が継続的に再描画されているためです。カーソルの下にあるテーブル行だけを対象としたより複雑なロジックを導入すればこれを回避することもできますが、それは本プロジェクトの目的ではありません。
作者: Artyom Trishkin